Powered by

Powered by
BLOG
 最終更新日:
この記事の結論
目次 ➖
「来月の売上はどうなる?」「需要の波をどう先読みする?」
このような問いに答えるために、今、多くの企業が注目しているのが予測モデルです。
予測モデルとは、過去のデータをもとに未来の数値や行動を推定する仕組みであり、機械学習やAIの発展とともに、あらゆる業界で活用が広がっています。
本記事では、予測モデルの基本的な仕組みや種類、機械学習との関係性、主要なアルゴリズム、実際の活用事例、導入時の注意点までを網羅的に解説します。
また、現場のデータ活用を支援する便利なAIツールもあわせてご紹介しますので、これから予測モデルを導入したい方や、データ活用に課題を感じている方はぜひ参考にしてください。
予測モデルとは、過去のデータをもとに未来の出来事や傾向を予測するための数学的・計算的な仕組みです。
統計学の領域では、データに基づく数式モデルを構築し、一定のパターンを見出して予測を行います。
一方、機械学習の分野では、コンピュータが大量のデータから自動的にルールや法則を学習し、それを使って未知のデータに対して予測を行います。
たとえば、ある商品の過去の販売実績や気温、広告費などのデータをもとに、来月の売上を予測するモデルも予測モデルに該当します。
こうしたモデルは、数式ベースのシンプルな回帰分析から、ニューラルネットワークのような高度なAI技術まで、幅広いアプローチが存在します。
予測モデルにはいくつかのタイプがあり、目的に応じて使い分けられます。
| 種類 | 予測するもの | 活用例 |
|---|---|---|
| 回帰 | 連続した数値 | 売上金額、価格、需要量 |
| 分類 | カテゴリや状態 | 解約の有無、スパム判定 |
| 時系列予測 | 時間とともに変化する数値 | 売上、需要、株価 |
現代のビジネスや研究において、将来を見通す力は極めて重要です。
不確実性が高まる中、過去のデータから「次に何が起こるのか」を事前に把握することで、リスクを減らし、より良い意思決定が可能になります。
たとえば小売業では、需要予測によって在庫を最適化し、売り逃しや余剰在庫の発生を防ぐことができます。
マーケティングでは、顧客の購買行動を予測して、最適なタイミングでプロモーションを仕掛けることが可能になります。
さらに、医療分野では、患者の病気リスクを予測することで、早期治療や予防に役立てることができます。
このように、予測モデルとは、あらゆる業界においてデータ活用の要となる技術であり、意思決定の質とスピードを大きく左右する存在なのです。
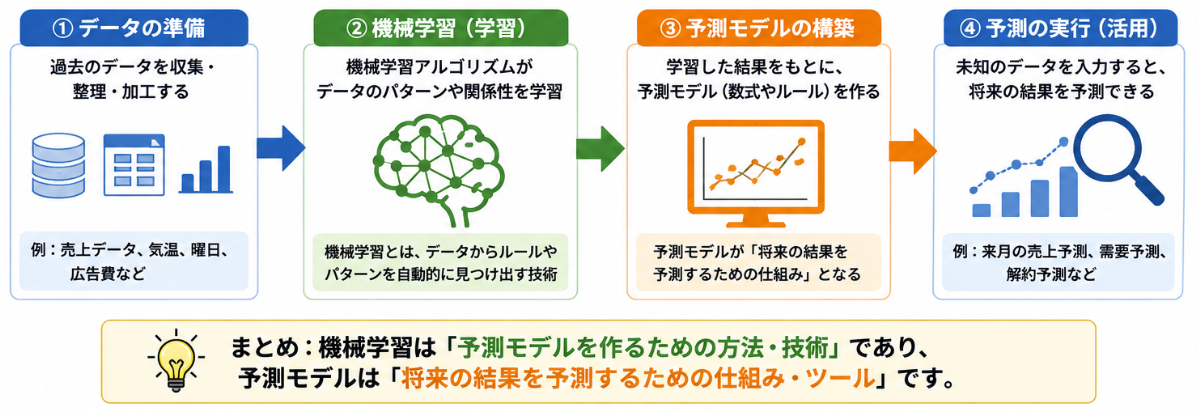
機械学習とは、コンピュータがデータからパターンを学習し、明示的なプログラムなしに判断や予測を行う技術です。近年では、ビジネスから医療、製造業まで幅広い分野で活用されており、予測モデルとは切っても切り離せない関係にあります。
機械学習は、大きく分けて以下の3つに分類されます。
教師あり学習は、最も一般的な機械学習手法であり、「正解ラベル付きのデータ」から学習する方法です。
たとえば、過去の売上実績(説明変数)と実際の売上結果(目的変数)をセットにしてモデルを構築し、将来の売上を予測する予測モデルを作成します。
主な手法には以下があります。
予測モデルは、多くの場合この教師あり学習をベースに構築されます。
教師なし学習は、ラベルのないデータからパターンや構造を見つけ出す手法です。
たとえば、顧客データに基づいて「行動パターンが似たグループを自動的に抽出するクラスタリング」などがあります。
活用例:
予測というよりは「洞察の抽出」や「前処理としての特徴発見」に用いられることが多く、予測モデル構築の補助的な役割も果たします。
強化学習は、環境との相互作用を通じて「報酬を最大化するための行動」を学習する手法です。
自動運転やゲームAIなどの「試行錯誤によって最適な行動方針を学ぶ場面」に用いられます。
一見すると予測とは異なるように見えますが、行動結果の「期待報酬」を予測するモデルを内包しており、ここでも予測モデルは重要な役割を果たします。
このように、機械学習の各分類は、それぞれ異なるアプローチでデータを学習し、目的に応じて予測モデルの構築や活用に使われます。
予測モデルとは、さまざまな業界や業務領域で活用されているデータ分析の中心的な手法ですが、その適用範囲は非常に広く、業種を問わず、未来の変化を先読みするために導入が進んでいます。以下に、代表的な活用シーンを紹介します。
売上予測、需要予測、在庫管理、価格最適化など、経営判断に関わる多くの場面で予測モデルが使われています。
たとえば小売業では、過去の販売実績や気象データをもとに来週の売上を予測し、仕入れや販促の計画に反映します。
顧客の購買行動や離反リスクの予測、広告効果の最適化などにも予測モデルが欠かせません。
たとえば、Webの閲覧履歴や購買履歴から「次に何を買いそうか」を予測するレコメンドシステムは、代表的な予測モデルの応用例です。
病気の発症リスクや重症化の可能性を予測するモデルが医療現場で活用されています。
たとえば、患者の年齢や血液検査結果などのデータをもとに、糖尿病や心疾患のリスクを早期に判断する予測モデルが登場しています。
融資審査やクレジットスコアリング、株価予測、不正取引の検出など、金融分野はデータ活用が非常に進んでいます。
とくに信用リスクの予測モデルは、銀行や保険業界において欠かせない存在となっています。
このように、予測モデルとは「未来を予測する力」を業務に組み込むことで、意思決定をより賢く、スピーディにするための基盤技術なのです。
業種や用途を問わず、予測モデルの活用は今後ますます重要性を増していくでしょう。
近年、ビッグデータの活用やAI技術の発展により、予測モデルの精度は飛躍的に向上しています。
その背景には、データの量・質・多様性の進化と、それを処理できるアルゴリズムやコンピュータ性能の進歩があります。
かつての予測モデルは、売上や人口など、構造化された限られた数値データを中心に構築されていました。
しかし今では、SNS投稿、気象情報、IoTセンサー、画像・音声データなど、非構造データも含めて多様な情報を扱えるようになりました。
これにより、たとえば顧客の感情や行動パターンまでも含んだ、より現実に即した予測モデルの構築が可能となっています。
ディープラーニングをはじめとする高度な機械学習アルゴリズムが登場し、複雑なパターンを学習できるようになったことも、予測精度の向上に大きく貢献しています。
さらに、GPUなどの高性能ハードウェアやクラウド環境の普及により、大量のデータ処理やモデルのトレーニングが高速化されています。
現場からのフィードバックを活用し、予測結果と実績との差異を分析・学習する仕組み(再学習)も一般化しています。
これにより、予測モデルは「一度作って終わり」ではなく、「使いながら進化し続ける仕組み」へと進化しているのです。
このように、データ活用の進化が予測モデルの精度を高め、より高度な意思決定や業務改善に直結しています。
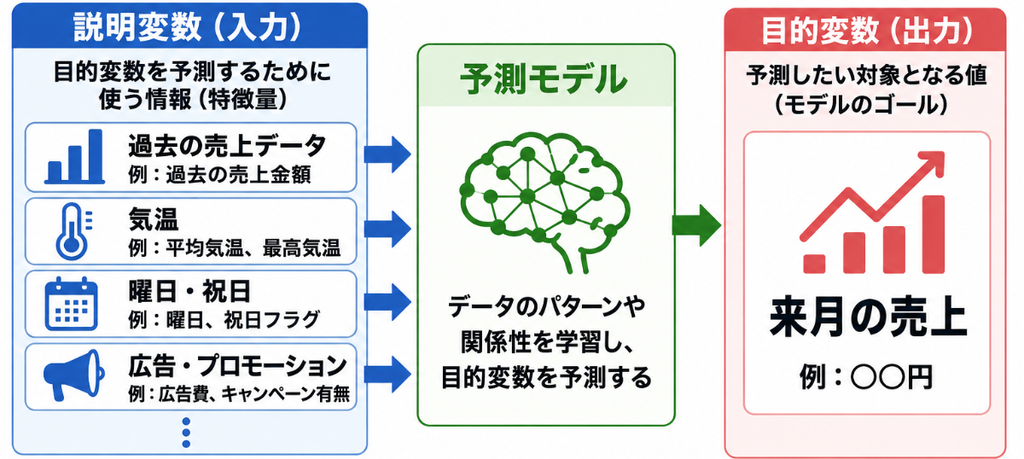
予測モデルとは、未来の結果や傾向を数理的に予測する仕組みですが、その構築において非常に重要なのが、「目的変数」と「説明変数」という2つの要素です。これらを正しく理解し、適切に設定することが、モデルの精度を大きく左右します。
| 項目 | 目的変数 | 説明変数 |
|---|---|---|
| 意味 | 予測したい対象 | 予測するために使う情報 |
| 役割 | 予測モデルのゴール | 予測の手がかり |
| 売上予測の例 | 来月の売上 | 過去の売上、気温、曜日、広告費 |
| 需要予測の例 | 次月の需要量 | 過去の需要、天候、販促、祝日 |
目的変数とは、モデルが予測したい対象の値や状態を指します。
たとえば「来月の売上金額」や「顧客が解約するか否か」などが該当します。
この目的変数を正確に予測することが、予測モデルの最終的なゴールです。
一方、説明変数は、目的変数を予測するために用いる情報・要因です。
たとえば売上を予測する場合、過去の売上、広告費、気温、曜日、キャンペーン情報などが説明変数になり得ます。
説明変数が目的変数にどのような影響を与えているのかをモデルが学習し、それをもとに将来を予測するというのが、予測モデルの基本的な仕組みです。
このように、「目的変数=予測したいもの」「説明変数=予測の手がかり」という関係にあります。
予測モデルとは、この2つの関係性を数式やアルゴリズムによってモデル化し、未知のデータに対しても結果を推定できるようにするものです。
予測モデルとは、目的変数と説明変数の関係性を学習して未来を予測する仕組みです。そのため、どのような変数を使うか=変数設計がモデルの精度を決定づける最大の要素のひとつとなります。
どんなに高度なアルゴリズムを使っても、入力となる説明変数の質が悪ければ、正確な予測はできません。
たとえば、売上を予測する際に、実際には売上に影響していない変数(例:社員の身長や社員番号など)を入れてしまうと、ノイズが増え、モデルの性能はかえって低下してしまいます。
正しい変数設計では、以下の2点が特に重要です。
これらを無視すると、予測モデルとは名ばかりの信頼できないツールになってしまい、現場での意思決定にも悪影響を及ぼします。
さらに一歩進んで、複数の変数を組み合わせたり、集計・変換することで新たな説明変数(特徴量)を作り出す技術を「特徴量エンジニアリング」と呼びます。
この工程は、モデル精度の向上に最も寄与するとも言われる重要なステップであり、実践的な予測モデルの構築では欠かせません。
このように、予測モデルは単にアルゴリズムを選ぶだけではなく、変数設計の巧拙が成否を大きく左右する分析プロセスなのです。
質の高い変数設計こそが、ビジネスに役立つ「当たる予測」を実現する鍵と言えるでしょう。
予測モデルは、過去のデータから将来の結果を見通すための強力なツールですが、ここでは実際のビジネスシーンにおける活用例を見ていきましょう。
あるアパレル企業では、店舗別の過去の売上データ、天候、曜日、イベント情報などをもとに、来週の売上を予測するモデルを構築しました。
このように、売上に影響を与えると考えられる要因を適切に選び、説明変数としてモデルに取り込むことで、精度の高い予測モデルが完成します。
売上予測について詳しく知りたい方はこちらの記事をご覧ください。
AI技術がどのように売上予測の精度を高め、業務効率を向上させるのかがよくわかる内容になっています。
売上予測にAIを活用する4つのメリット|導入成功のコツまで解説
食品メーカーでは、季節や地域ごとの需要の違いを加味した商品出荷量の予測モデルを導入しています。
このような予測モデルにより、無駄な在庫を減らし、欠品を防ぐと同時に、物流コストや廃棄ロスの削減にも貢献しています。
需要の変動が大きい業界ほど、予測モデルの導入による業務改善効果は大きく、競争力の強化にもつながるのです。
このように、予測モデルとは単なる理論ではなく、実際の業務課題を解決するために日々活用されている実践的なツールです。
売上予測や需要予測に限らず、あらゆる分野で「未来を見通す力」を提供し、意思決定の質を高める役割を担っています。
需要予測モデルについて詳しく知りたい方はこちらの記事をご覧ください。
需要予測で使われる主なモデルや、需要予測をおこなう際の注意点がよくわかる内容になっています。
需要予測モデルとは?需要予測をおこなう際の注意点やおすすめツールについて徹底解説!
| 種類 | 主な手法・アルゴリズム | 特徴 | 向いている場面 |
|---|---|---|---|
| 回帰モデル | 単回帰、重回帰、リッジ回帰など | 数値予測に適している | 売上・価格・需要量の予測 |
| 分類モデル | ロジスティック回帰、SVM、k-NNなど | カテゴリの予測に適している | 離反予測、異常検知 |
| 決定木・ランダムフォレスト | 決定木、ランダムフォレスト | 説明性と精度のバランスが良い | 判断根拠を確認したい場面 |
| ニューラルネットワーク | ディープラーニングなど | 複雑なパターンを学習できる | 大量データを使った高度な予測 |
回帰モデルとは、連続的な数値を予測するための代表的な予測モデルの一種です。
たとえば「来月の売上はいくらか」「広告費が○万円なら、どれだけ集客できるか」といった数値予測に特化しています。
代表的な手法:
予測モデルとは、こうした回帰分析をベースに精度を高め、実務で使える形へと発展させたものです。
分類モデルは、ある対象がどのカテゴリに属するかを予測するモデルです。
たとえば「この顧客は解約するか?しないか?」「この取引は不正か?正常か?」など、カテゴリを判断する場面で使われます。
代表的な手法:
決定木は、データを分岐しながら目的変数を予測するアルゴリズムで、直感的で解釈しやすい点が魅力です。
「ある条件のときはこうなる」というルールが可視化されるため、説明性の高い予測モデルとして重宝されています。
さらに精度を高めたのがランダムフォレストです。
これは、複数の決定木をランダムに構築し、結果を平均化または多数決で統合するアンサンブル手法で、高い精度と汎化性能を両立しています。
ニューラルネットワークは、人間の脳の構造を模したモデルで、膨大なパターンを自動で学習できる高度な予測手法です。
近年では、深層学習(ディープラーニング)によって画像認識や音声処理などでも大きな成果を上げています。
特徴:
たとえば需要予測や価格予測など、従来の回帰や分類では対応しきれない複雑なパターンを捉える場面で活躍します。
それぞれの予測アルゴリズムには得意分野と限界があります。選定の際は、予測の目的、データの特性、必要な説明性、リソース(計算コスト)などを総合的に判断することが重要です。
| モデル名 | 特徴 | 向いている場面 |
|---|---|---|
| 回帰モデル | 数値予測、実装が容易 | 売上・価格・在庫量の予測 |
| 分類モデル | カテゴリ分けに強い | 離反予測、異常検知 |
| 決定木・ランダムフォレスト | 説明性と精度のバランスが良い | 業務説明が必要な現場向き |
| ニューラルネットワーク | 複雑なパターンの学習に強い | ビッグデータ、高精度が求められる場面 |
予測モデルは、目的に応じて適切なアルゴリズムを選ぶことで、その真価を発揮する技術です。
ツールや手法に頼るだけでなく、「なにを予測したいのか」「どのような結果を活用したいのか」という視点から選定することが、成功への第一歩となります。
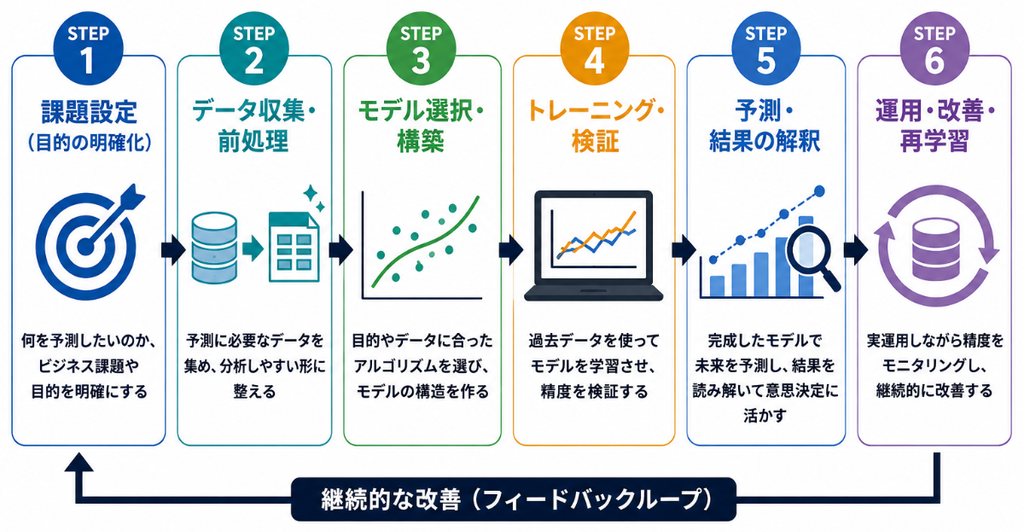
予測モデルは、ただデータを投入すれば自動で未来を当ててくれる魔法の箱ではありません。
まず最初に行うべきは、「何を予測したいのか」「予測結果をどう活用するのか」といった課題の明確化です。
例:
このステップが曖昧だと、後続のモデリングや評価にズレが生じ、実務に使えない予測モデルになってしまう恐れがあります。
次に行うのが、目的に適したデータの収集と整備(前処理)です。
予測モデルは、データに基づいて構築されるため、データの質がそのままモデルの質を左右します。
代表的な前処理項目:
また、将来の情報を含むデータを誤って使ってしまう「情報漏洩」にも注意が必要です。
データが整ったら、予測の目的や条件に応じて最適なアルゴリズム(予測手法)を選択します。
たとえば、連続値を予測するなら回帰モデル、カテゴリ分けなら分類モデルが適しています。
この段階で行うこと:
予測モデルは、目的とデータに合った構築戦略があってこそ、その性能を最大限に発揮できます。
構築したモデルは、学習用データでトレーニングし、テストデータやクロスバリデーションで性能を検証します。
評価指標の例:
また、学習用データに過度に最適化された「過学習(オーバーフィッティング)」にも注意が必要です。
予測モデルは、過去だけでなく未来のデータに対しても通用する汎化能力が求められる技術です。
モデルが完成したら、未知のデータに対して予測を実施し、その結果を業務にどう活用するかを検討します。
この段階で重要なのは、
最後のステップは、実際の業務にモデルを組み込み、継続的に改善・更新していくフェーズです。
予測モデルは一度作って終わりではなく、使いながら磨いていく「継続運用型の仕組み」だと捉えることが大切です。
予測モデルは、ビジネスにおける意思決定のスピードと精度を大きく向上させる武器です。とくに「売上予測」や「在庫管理」では、その効果が顕著に現れます。
たとえば小売業では、過去の販売実績、気温、曜日、イベント情報などをもとに翌週の売上を予測するモデルを導入することで、過剰在庫や欠品を防止し、無駄なコストを削減しています。
また、製造業においても、部品や原材料の適正在庫を維持するために、需要を正確に予測する予測モデルが不可欠です。
需要変動に合わせた仕入れと生産調整を実現できる点が、ビジネスにおける大きな競争優位につながります。
マーケティング分野では、顧客の行動パターンや将来のニーズを先読みするために予測モデルが活用されています。
たとえばECサイトでは、「このユーザーは次に何を買いそうか」を予測して、パーソナライズされたレコメンドを提示する仕組みがあります。
また、広告の配信タイミングや内容を最適化するために、過去のクリック率や購買履歴をもとに顧客の反応を予測するケースも増えています。
予測モデルとは、マーケティング施策のROIを最大化するために欠かせないデータドリブンなアプローチであり、勘や経験に頼らない戦略設計を実現します。
医療分野では、予測モデルが「命を守る」ための意思決定に活用されています。
たとえば、年齢・血圧・糖尿病歴・家族歴などのデータをもとに、心疾患やがんの発症リスクを予測するモデルが実用化されています。
このようなモデルを活用することで、リスクの高い患者を早期に特定し、予防的な介入や検査の提案が可能になります。
また、手術後の合併症リスクや再入院の可能性など、医療リソースの最適配置にも役立てられています。
金融業界は、データ活用が非常に進んでいる分野であり、予測モデルは日常業務の中核を担っています。
代表例としては、個人や企業の信用スコアの予測モデルがあります。これにより、過去の返済履歴や収入、年齢などをもとに「貸しても大丈夫か?」を事前に判断できます。
また、株価や為替のような市場データに対して、時系列モデルやディープラーニングを用いた価格予測も行われており、投資判断の高度化やリスク管理に貢献しています。
予測モデルは、金融における「収益機会の最大化」と「リスクの最小化」を両立させるための鍵なのです。
予測モデルとは、過去のデータに基づいて未来を予測する仕組みですが、学習しすぎること(=過学習)によって逆に精度が落ちてしまうことがあります。
過学習とは、モデルが学習用データに過度に適合し、ノイズや偶然のパターンまで覚えてしまう現象です。
その結果、未知のデータ(本番環境)に対しては正確な予測ができなくなってしまいます。
防止するには:
「正しく当てる」よりも「汎用性のある予測」が大切だということを忘れないようにしましょう。
予測モデルとは、あくまでデータに依存して作られるものです。
そのため、入力となるデータの「質」と「量」が不十分であれば、どんなアルゴリズムを使っても良い結果は出ません。
注意すべき点:
高品質で多様なデータがあってこそ、予測モデルは本来の性能を発揮できます。
「良いデータがすべての土台である」という意識を持つことが重要です。
どんな予測モデルでも、完全に未来を当てることはできません。
したがって、「どの程度の誤差であれば業務に許容されるのか」を明確にしておくことが重要です。
例:
このように、予測精度とビジネスリスクのバランスを評価しておくことで、「活用できる予測モデルかどうか」が判断できるようになります。
とくに複雑なモデル(例:ディープラーニング)では、「なぜその予測になったのかが説明できない」というブラックボックス問題が発生します。
これにより、現場の担当者や経営層がモデルの結果を信頼できず、活用が進まないという課題も生まれています。
対処方法:
予測モデルとは、過去のデータから未来を見通し、より良い意思決定を支援するための技術です。
その本質は、単なる数式やAIの仕組みではなく、「現場の判断力を高めるための知的ツール」であると言えるでしょう。
本記事では、以下のポイントを中心に解説してきました。
これらを通じて、予測モデルとは単にデータを分析するための技術ではなく、組織全体の意思決定の質とスピードを変える“戦略的な資産”であることがご理解いただけたのではないでしょうか。
今後、予測精度の向上やツールの進化により、より多くの現場がデータと予測を“自らの力”として活用できる時代が到来しています。
もしあなたの職場でも、「予測によって未来を変えたい」という課題があるなら、予測モデルの導入・活用に一歩踏み出してみてはいかがでしょうか。
Deep Predictorは、さまざまな予測業務を、実際の業務判断・アクションまでつなげるAI予測運用・意思決定支援サービスです。
自社の保有データに加え、気象・カレンダー・経済・人口統計などの外部データを活用し、売上・販売数・来客数・CVRなど、業務に必要な数値を高精度に予測します。
さらに、予測結果を出すだけでなく、発注量の算出や出荷調整、価格最適化など、現場ですぐに活用できる形への変換にも対応。数万〜数十万SKUの大規模な予測や、基幹システム・ERPとのAPI連携、データの取り込み・加工・更新の自動化にも対応しています。
導入して終わりではなく、運用が継続的に回る業務の仕組みづくりを、定着まで専任担当が伴走支援。予測AIを日々の業務に組み込み、継続的に活用できる環境づくりを支援します。
本記事で扱ったように、予測モデルを日々の業務に活用する際にも、Deep Predictorは予測から業務判断・アクションまでを支援するサービスとして活用できます。
予測モデルとは、過去のデータから一定のパターンや関係性を学習し、将来の数値や出来事、行動などを予測するための仕組みです。売上予測や需要予測、顧客の解約予測など、さまざまな用途に活用されています。
機械学習は、コンピュータがデータからパターンやルールを学習する技術です。一方、予測モデルは、その学習結果などを利用して未知のデータに対する数値や分類結果を予測する仕組みを指します。機械学習は、予測モデルを構築するための代表的な方法のひとつです。
予測モデルには、売上や需要量などの数値を予測する「回帰モデル」、顧客の解約有無などを予測する「分類モデル」、時間の経過に沿った変化を予測する「時系列モデル」などがあります。目的やデータの特性に合わせて適切なモデルを選ぶことが重要です。
予測精度を高めるには、十分な量と質のデータを用意し、目的変数や説明変数を適切に設定することが重要です。また、目的に合ったアルゴリズムを選び、予測結果と実績の差を確認しながら、モデルの再学習や改善を継続することも欠かせません。
近年は、専門的なプログラミングや機械学習の知識がなくても利用できるAIツールが登場しています。こうしたツールを活用すれば、データの準備やモデル構築にかかる負担を抑えながら、需要予測や売上予測などを業務に取り入れることが可能です。


 パートナー募集ページはこちら